動画のアップスケールでは、仕上がりの画質や処理時間に加え、使用するPCのスペックも関わります。
ComfyUIではRelayVSRの2倍と4倍のアップスケールが行える公式テンプレートが用意されています。
RelayVSRとは
RelayVSRは、大型の生成モデルと軽量なデコーダーを連携させて動画を高解像度化します。大型モデルは一定間隔のキーフレームから参照情報を作り、軽量モデルはその参照情報と元動画の各フレームを使って、拡大後の映像を生成します。
大型モデルをすべてのフレームに適用する場合に比べ、処理量を抑えながら動画全体の細部と時間的な一貫性を保つ構成です。元映像の内容を基に細部を生成するので、ぼやけていた文字や服の細かい模様が鮮明に復元されるとともに、人物の顔のしわや陰影が強調さえてしまうことがあります。
RelayVSR 2xと4xの違い
RelayVSRの原版は縦横4倍のモデルです。RelayVSR 2xは、処理負荷を抑えるためにLightX2Vがモデルの構造を変更し、追加学習した縦横2倍のモデルです。
| モデル | 拡大倍率 |
|---|---|
| RelayVSR 2x | 縦横2倍 |
| RelayVSR 4x | 縦横4倍 |
ComfyUIでの利用
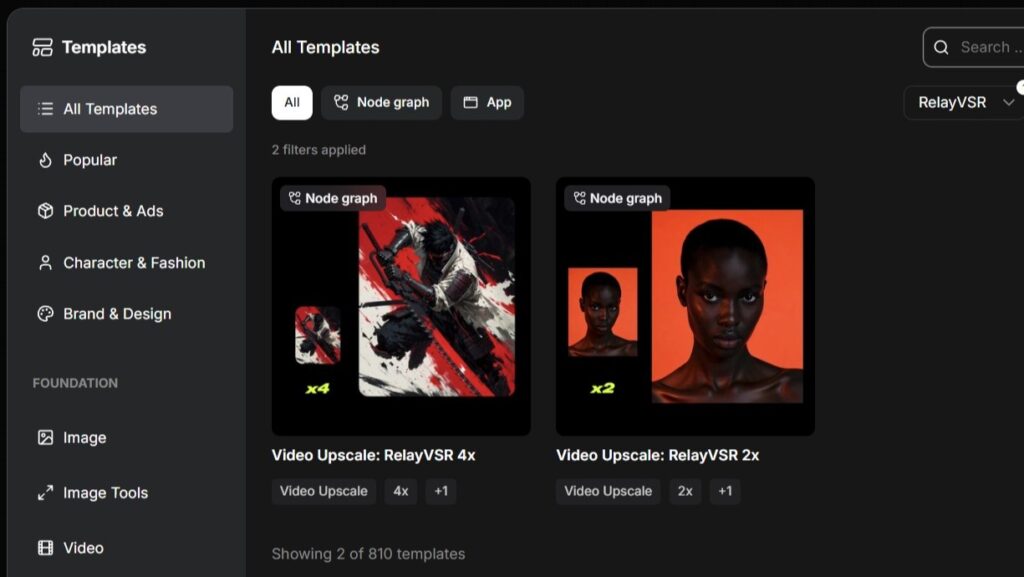
ComfyUIにはRelayVSRの処理が組み込まれており、2xと4xの公式ワークフローが用意されています。Comfy-Orgはそれぞれに対応する拡散モデルとFlashデコーダーを配布しています。
拡散モデルは ComfyUI/models/diffusion_models/ に配置します。
- RelayVSR 2x:
relayvsr_x2_lightx2v_int8_convrot.safetensors - RelayVSR 4x:
relayvsr_x4_int8_convrot.safetensors
Flashデコーダーは ComfyUI/models/vae/ に配置します。
- RelayVSR 2x:
relayvsr_flash_vae_x2_fp32.safetensors - RelayVSR 4x:
relayvsr_flash_vae_x4_fp32.safetensors
2xまたは4xで、同じ倍率の拡散モデルとFlashデコーダーを組み合わせます。RelayVSR Conditioningは入力動画から処理用の情報を作り、VSR Decodeは元のフレームと潜在データを使って拡大後の画像を生成します。
VSR Decodeのdetailは、モデルが追加する細部の強さを調整する設定です。1.0では生成した細部を全量使い、値を下げると追加される細部が弱まります。0ではバイキュービック法による拡大画像になります。
生成比較
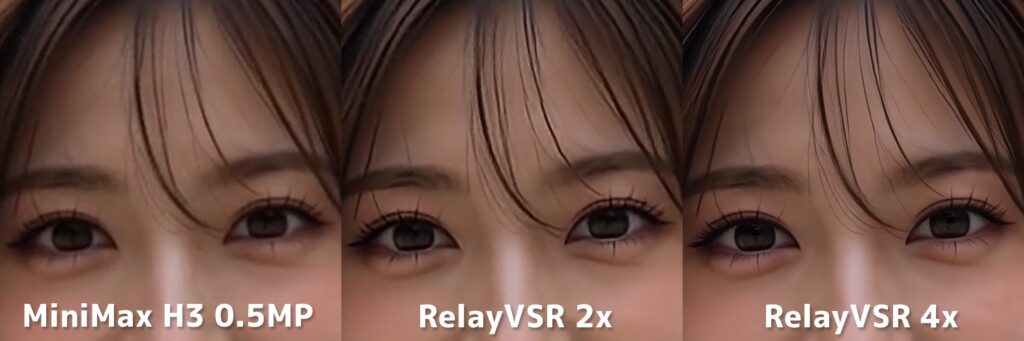
RelayVSRは、キーフレームを扱う大型モデルと各フレームを処理する軽量デコーダーを組み合わせた動画超解像モデルです。2xはLightX2Vが追加学習したモデル、4xは原版のモデルで、それぞれ異なる解像度と質感の出力が得られます。
利用者の反応
利用者の比較では、短時間で細部を補える点が評価される一方、肌や髪の強調、動きのある場面のちらつきにも意見が出ています。
- MiniMax H3動画を704 × 1248から1080 × 1920へ拡大した例では、Lanczos拡大より細かな質感が増え、ちらつきも少し減少
- MiniMax H3の12.25秒・294フレームをRTX 4090で比較した例では、4xは66秒で処理され、低解像度の入力からでもSeedVR2に近い仕上がりと評価された一方、肌はやや人工的な印象
- 同じ比較の2xでは細部が多く見えた一方、
detail1.0の目や髪は強調されすぎた印象となり、別の動画では遠景の顔に眼鏡が現れた例も報告 - 動きの速い動画では、顔の細部がフレームごとに現れたり消えたりして、脈打つように見える例
- Hi8映像12本の比較では、静止したカメラの場面でRelayVSRを高く評価する一方、カメラや人物が動く場面と細かな質感ではStarlightを評価
まとめ
ミドルスペックPCで、1MPの4倍アップスケール、5504×3072サイズ(5K以上)でもOOM起こさずに生成できました。
私の環境でSeedVR2が2倍でエラー起こすことを考えたら、かなり使いやすいアップスケーラーだと思います。
参考URL