Pika H3 Flexは、MiniMax H3を映像・音声データで追加学習し、50ステップのモデルを6ステップに蒸留し、画質やプロンプトへの追従性を高める学習を加えています。
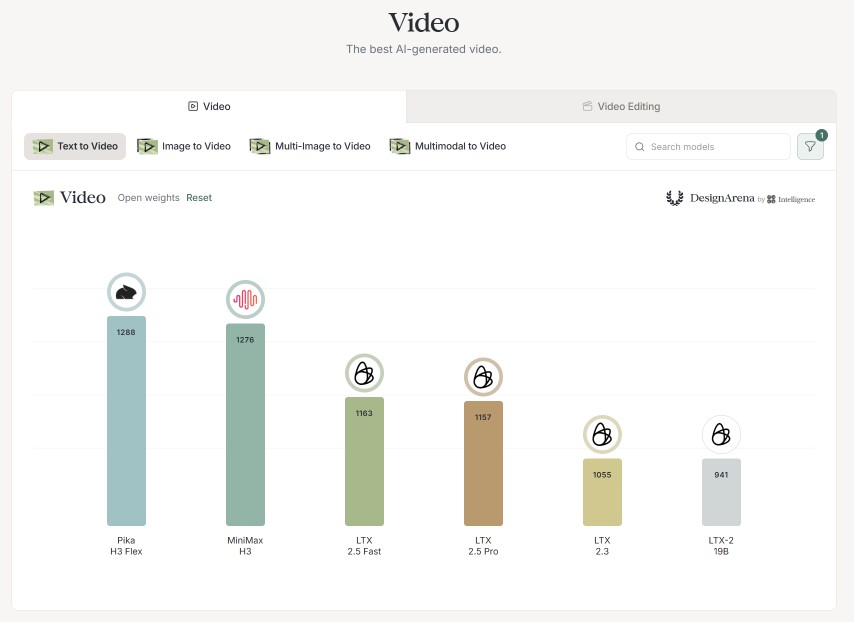
DesignArenaのテキストからの動画生成ランキングで、オープンウェイトモデルの中で1位を獲得しました。
3種類のComfyUIテンプレート
| テンプレート | 入力 | 動画の作り方 |
|---|---|---|
| Text to Video | テキスト | シーンや音声の説明から動画を生成 |
| FL2VA | 最初と最後の画像、テキスト | 2枚の画像を始点と終点にして、その間の動きを生成 |
| Reference to Video | 参照画像、テキスト | 人物や背景などの外見を参照し、指定した動きやシーンを生成 |
必要なファイル
MiniMax H3のモデルを導入みの場合は、Pika H3 FlexのLoRAをのみを追加します。
- Text to Video・FL2VA用:pika_h3_flex_fl2va_v1_bf16.safetensors
- Reference to Video用:pika_h3_flex_ref2va_v1_bf16.safetensors
生成してみた
RTX 4070 Ti SUPER 16GB RAM64GB環境で生成してみました。
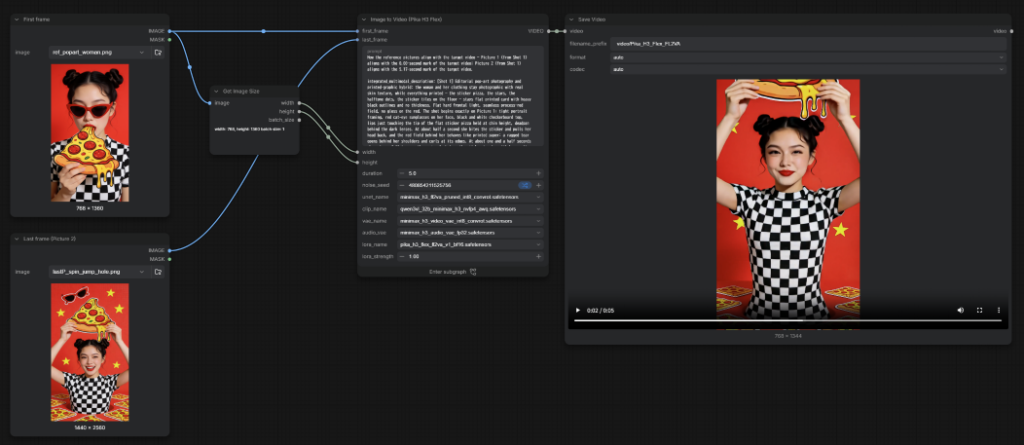
公式テンプレート Pika H3 Flex: RL2VA
1MP 768×1344 5秒
初回181秒、2回目以降平均約128秒
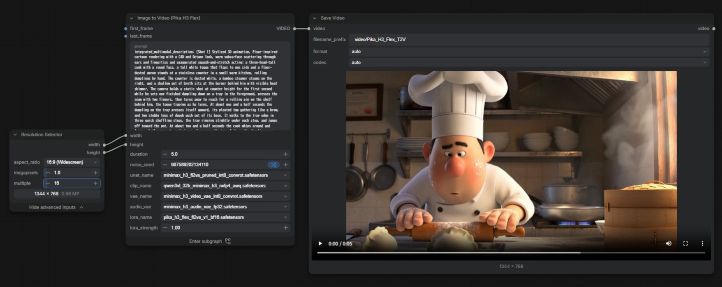
公式テンプレート Pika H3 Flex: Text to Video
1MP 1344×768 5秒
2回目以降平均約110秒
Text to Image 1MP 768×1376
DMAD 4step 平均約86秒
Pika 6step 平均約118秒 メモリの消費はVRAM14GB 共有メモリ26GB
LightX2V 8step 平均約157秒
通常 20step 平均約330秒
メモリの消費量は20stepだけが共有メモリ24GBで他は概ね同等でした。
Ref2V 1MP 768×1376
DMAD 4step 平均約113秒
Pika 6step 平均約160秒
LightX2V 8step 平均約210秒
通常 20step 平均約510秒
まとめ
画質は8step・20stepと比較して遜色ないレベルか、むしろ一番好みの画質でした。
MiniMax H3は多くのモデルやLoRA・ツールがあるのでこの比較だけでは優劣付けにくいですが。
コミュニティでの利用者の反応
- 生成が速く、通常のショットはまとまりがよい
- プロンプトを詰めるための試行錯誤に使いやすい
- 激しい格闘シーンでは、手足が崩れる場合がある
- 高速化LoRAの中で一番気に入っている
- 他の追加学習モデルや高速化モデルと比べ、画質が特別良いとは感じない
- 階段を駆け下りる人物の比較では、顔と音声も自作ワークフローより良かった
利用条件
ローカル向けのPika H3 Flexは、480pまたは768pの映像とミックス済みのステレオ音声を出力します。Pikaの公開するローカル推論パッケージでは、5〜15秒、24fpsの動画に対応しています。
Pika H3 FlexのLoRAには、MiniMax H3 Community License Agreementが適用されます。利用や再配布の際はライセンス本文と付属の通知を確認してください。