MiniMax H3のComfyUI環境には、2〜4ステップで生成する高速化LoRA、参照素材を保存して使い回すRefMods、動作を指定するControlNet、映像と音声をつないで長尺化するワークフローがそろっています。高速化も、生成ステップを減らす方法、途中の計算を予測・再利用する方法、低解像度で生成してから仕上げる方法に分かれています。
Redditのr/StableDiffusionとr/comfyuiでは、RefModsの参照精度、FastH3の速度と画質、アップスケール、長尺動画の継ぎ目について具体的な作例や利用者の議論が続いています。DMADやPDMDの低ステップ生成に加えて、制作の操作を変えるツールも押さえておくと、現在のH3でできることを把握しやすくなります。
- 用途ごとに選ぶH3のツール
- DMAD:映像と音声を4ステップで生成するLoRA
- PDMD:2ステップと4ステップの高速化LoRA
- FastH3 V2:8ステップ生成とSparse Attentionを組み合わせるモデル
- LightX2V Turbo:4・8ステップ生成の高速化LoRA
- Spectrum:途中の特徴を予測してTransformer計算を減らす
- FirstBlockCache:変化が小さいステップで後段の計算を再利用する
- RefModsとFantastic Prompt Builder:人物・声・参照素材を再利用する
- H3 Latent Upscaler:低解像度で生成してから高解像度へ仕上げる
- Endless H3とMotion Context:動きと音声を引き継いで長尺化する
- Fun ControlNet Union 2.0:動作・構図・領域を映像で指定する
- LynnReal-Omni:4ステップと3ステップのH3派生モデル
用途ごとに選ぶH3のツール
H3の高速化と制作ツールは、処理する場所が異なります。候補を選ぶ際は、短縮したい処理や指定したい内容に対応させると整理しやすくなります。
| 目的 | 対応する候補 |
|---|---|
| 少ないステップで生成する | DMAD、PDMD、FastH3 V2、LightX2V Turbo LoRA、LynnReal |
| Transformerの実計算を減らす | Spectrum、FirstBlockCache |
| 低解像度から高解像度へ仕上げる | H3 Latent Upscaler |
| 人物・声・素材を繰り返し使う | RefMods、Fantastic Prompt Builder |
| 参照生成のモデル構成を変える | FL2VA・Ref2VAハイブリッド |
| 動きと音声をつないで長尺化する | Endless H3、Motion Context |
| ショットや途中の状態を管理する | Continuity、複数フレーム参照 |
| 動作・構図・編集領域を指定する | Fun ControlNet Union 2.0 |
| 動画デコードを軽くする | VAEの最適化、INT8 VAE、Light VAE |
高速化LoRAのステップ数、Sparse Attention、キャッシュ、アップスケール、VAEは、それぞれ生成時間の違う部分へ作用します。例えばサンプリングが短くなっても、高解像度の仕上げや動画デコードに時間がかかる構成はあります。配布者の速度比較を見る際は、GPU、モデル、解像度、尺に加え、サンプリングだけの時間か、読み込みやデコードを含む時間かを合わせて確認すると、使う構成を選びやすくなります。
DMAD:映像と音声を4ステップで生成するLoRA
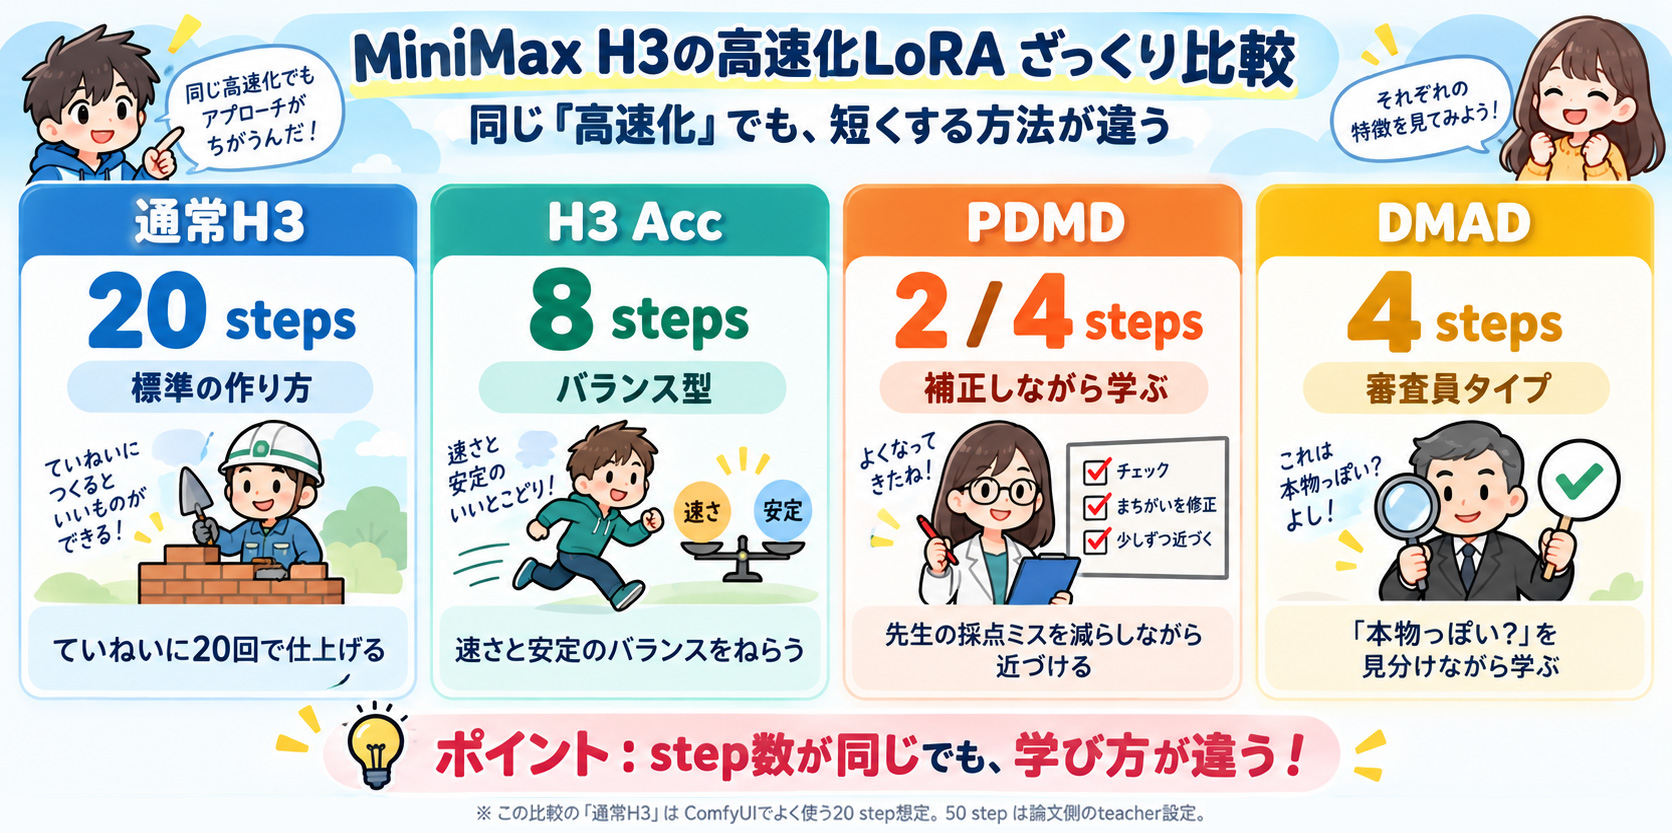
DMADは、MiniMax H3を少ないステップで動かすための蒸留手法です。Texas A&M UniversityとByteDanceの研究者が開発し、H3の50ステップの教師モデルから、映像とネイティブのステレオ音声を4ステップで生成するモデルを学習しています。配布形態はH3のTransformerに適用するLoRAです。DMADモデル
DMADは Distribution Matching as Adversarial Distillation の略です。
- D:Distribution(分布) — 多数の映像や音声に表れる特徴の傾向です。
- M:Matching(一致させる) — 少ないステップで生成した結果の傾向を、実データや元のモデルの生成結果へ近づけます。
- A:Adversarial(敵対的) — 結果を「生成するモデル」と、その結果を実データや元のモデルの結果から「見分けるモデル」が、互いの結果を受けて学習する方法です。
- D:Distillation(蒸留) — 元のモデルの生成能力を、少ないステップで動くモデルへ学習させることです。
名称全体は、「生成結果の傾向をそろえる学習を、生成する側と見分ける側を競わせる蒸留として行う」という意味です。学習中は、見分ける側の判定を使って、少ないステップで生成する側を改善します。H3用DMADは、この学習で得た変更をLoRAとして適用し、映像と音声の4ステップ生成を狙います。開発元の説明、DMAD論文
研究チームの人間による映像・音声の総合比較では、引き分けを除いたDMADの選好率がDMD2に対して79.1%、rCMに対して84.6%でした。この数値は論文中の比較条件における評価で、通常のH3に対する勝率とは比較対象が異なります。評価結果
元配布の2種類とComfyUI向け変換版
元配布には、学習時のcriticの構成が異なる2種類があります。どちらもランク128、約1.4 GBのLoRAで、作者の推論コードやDiffusersで使う形式です。ComfyUIの通常のLoRA読み込みには、ComfyUI向けに変換されたファイルを使います。
- lora_critic:論文の主実験に対応するチェックポイントです。
- full_critic:criticのバックボーン全体を学習した別の実験に対応します。研究チームのAVGen-Bench評価では、こちらが高いスコアを得ています。
Kijai氏はfull_critic側のComfyUI向け変換版を公開しています。ファイル名は minimax_h3_DMAD_4step_full_lora_avg_rank_39_bf16.safetensors、表示容量は367 MBです。元のランク128から削減された配布物なので、論文の評価値と変換版の出力は分けて扱う必要があります。元配布の内訳、Kijai氏の配布ファイル
元実装の参照設定は、4ステップ、動画シフト12、音声シフト2、1344×768、124フレーム、24fpsです。classifier-free guidanceを追加しない構成で、論文用サンプラーには各ステップで再びノイズを加えるre-noiseの規則があります。ComfyUI変換版の専用推奨サンプラーは未確認です。元実装の設定と、ComfyUIで使うワークフローの設定を照合して使用する対象です。DMADの推論実装
Redditでは10月2日の紹介投稿に反応が集まり、T2VAへの対応範囲も質問されています。配布されたH3モデルの対象は、テキストから映像と音声を生成するT2VAです。RedditのDMAD投稿
hfmaster配布によるランク維持版minimax_h3_DMAD_4step_full_critic_rank128_comfy.safetensors
容量は約1.96GBです。公開ファイルのヘッダーに、通常部分はrank 128、QKV結合部分は3×128=384を維持、変換情報にも lossless と記載されています。
PDMD:2ステップと4ステップの高速化LoRA
PDMDは「Projected Distribution Matching Distillation」の略で、DMDの学習時の更新方向を調整する蒸留手法です。H3用には2-NFE版と4-NFE版があり、2回または4回のモデル評価で生成するためのLoRAが配布されています。Transformerへ適用し、テキストエンコーダー、動画VAE、音声VAEなどはベースモデルの構成を使います。PDMD 2-NFE、PDMD 4-NFE
元配布のLoRAはランク128で、BF16版が約1.38 GBです。LoRAの適用スケールは1.0、動画シフト12・音声シフト3を使います。2-NFE版には1344×768、345フレーム、24fpsの参照生成条件があります。2-NFEの設定と配布内容
ComfyUI向けには、Kijai氏による変換・ランク削減版があります。
- 2ステップ用・381 MB
minimax_h3_pdmd_2step_lora_avg_rank_38_bf16.safetensors - 4ステップ用・559 MB
minimax_h3_pdmd_4step_lora_avg_rank_57_bf16.safetensors
この容量はLoRAファイル自体の大きさです。H3のベースモデルとエンコーダー、VAEも使用します。Kijai氏のPDMD配布
DMADとPDMDは、どちらも低ステップ生成を狙うLoRAですが、学習方法と音声側の参照設定が異なります。
| 方式 | 元配布の生成回数・ステップ | 動画シフト | 音声シフト |
|---|---|---|---|
| DMAD | 4 | 12 | 2 |
| PDMD 2-NFE | 2 | 12 | 3 |
| PDMD 4-NFE | 4 | 12 | 3 |
| FastH3 V2 | 8 | 10 | 3 |
Redditの10月2日のニュースまとめでも、PDMD 2-NFEのComfyUI向け配布が取り上げられています。PDMDを含むニュースまとめ
FastH3 V2:8ステップ生成とSparse Attentionを組み合わせるモデル
FastH3 8-Step V2は、FastVideoによるH3の蒸留チェックポイントです。Data-Free DMD2とVSA-H3を使い、8回のTransformer評価で映像と音声を生成します。学習には80%の疎度のVideo Sparse Attentionを組み合わせています。FastH3 V2モデル
VSAは、映像のAttention計算を疎にする仕組みです。FastH3 V2では、ステップ削減とAttention計算の削減を組み合わせています。チェックポイントの学習対象はT2VAで、FL2VAとRef2VAは蒸留対象に含まれていません。ComfyUIにはT2VとI2Vのテンプレートがありますが、画像入力用テンプレートの存在と、モデルの蒸留対象はそれぞれ押さえる必要があります。モデルの対応範囲、ComfyUI向け配布
ComfyUIのT2Vテンプレートは、次の組み合わせを使っています。
| 項目 | 設定・構成 |
|---|---|
| 生成ステップ | 8 |
| サンプラー | res_multistep |
| スケジューラー | simple |
| シフト | 動画10・音声3 |
| Sparse Attention | BlockSparseAttentionのvsa |
| Attentionバックエンド | Comfy Kitchen Attention |
モデルとテンプレートを一組で導入し、必要な動画・音声VAE、テキストエンコーダーをそろえる構成です。ComfyUI T2Vテンプレート
Redditでは、既存のTurbo LoRAより速かったという利用者の報告と、肌の滑らかさ、難しい動き、音声品質への不満が並んでいます。FastVideoも難しい動作、細部、一部の音声でベースH3の品質に届かない可能性を挙げています。速度とともに、扱う場面への適性が議論されているモデルです。Redditの公開スレッド
LightX2V Turbo:4・8ステップ生成の高速化LoRA
LightX2VのMiniMax H3 Turboは、H3を4回または8回のモデル評価で動かすために蒸留した高速化LoRAです。H3のベースモデルへ追加して使い、テキストエンコーダー、動画VAE、音声VAEも組み合わせます。ComfyUI向けの配布版と作例ワークフローがあり、配布元のワークフローはComfyUI標準ノードで構成されています。モデル仕様、ComfyUI導入手順
テキスト・画像生成用と参照画像用、544p版と768p版
FL2VA用のLoRAは、テキストから映像と音声を作るT2VAと、開始・終了画像を使うFL2VAを対象にしています。I2VAでは開始画像を入力します。Ref2VA用は、参照画像を使って映像と音声を作る用途に向けた別のLoRAです。対応タスクと入力の違い
同じ「8-step v1.0」でも、ファイル名に768pが付く版と付かない版があります。768pなしのFL2VA 8-step v1.0は544p・複数の縦横比で学習され、768p版は1344×768で学習されています。生成解像度を768pへ変える操作と、768pで学習されたLoRAを選ぶ操作は、それぞれ設定する項目です。学習解像度とシフトの一覧
2026年10月4日時点では、FL2VA用の4-step v1.2 768pと、Ref2VA用の8-step v1.0 768pも公開されています。4-step v1.2は、4ステップ構成を保ちながらv1.1の音声品質を改善した版と作者が説明しています。作者の推奨設定は次のとおりです。
| 配布版 | ステップ | 動画シフト | 音声シフト |
|---|---|---|---|
| FL2VA 8-step v1.0(544p学習) | 8 | 12 | 3 |
| FL2VA 4-step v1.0 768p | 4 | 6 | 3 |
| FL2VA 4-step v1.2 768p | 4 | 6 | 3 |
| FL2VA 8-step v1.0 768p | 8 | 6 | 3 |
| Ref2VA 8-step v1.0 768p | 8 | 12 | 3 |
768p版の各公開投稿では、サンプラーにEulerを推奨しています。FL2VA 8-step v1.0 768pでは、スケジューラーにSimpleも指定されています。4-step v1.2の公開・設定、FL2VA 8-step 768pの公開・設定、Ref2VA 8-step 768pの公開・設定
ComfyUIでは、ファイル名にcomfyui_bf16が付いた版をComfyUI/models/loras/へ配置します。以下は各用途の配布ファイルで、Hugging Face上の表示容量はいずれも約1.96 GBです。
- 公式T2Vテンプレートの指定ファイル:FL2VA 8-step v1.0(544p学習)
minimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensors - FL2VA 4-step v1.2 768p
minimax_h3_fl2v_turbo_4step_v1.2_768p_comfyui_bf16.safetensors - FL2VA 8-step v1.0 768p
minimax_h3_fl2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors - Ref2VA 8-step v1.0 768p
minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors
ComfyUI公式テンプレートでの使い方
現在のComfyUI公式T2Vテンプレートは、LightX2Vのminimax_h3_fl2v_turbo_8step_v1.0_comfyui_bf16.safetensorsを初期選択しています。ワークフローのturbo_modeは、選択したLoRAの適用と生成ステップ数を切り替えるスイッチです。このLightX2V 8ステップ版を使う際は、turbo_modeをON、turbo_model_strengthを1.0、turbo_stepsを8に設定します。サンプラーはres_multistep、スケジューラーはsimpleです。turbo_modeをOFFにすると、LoRAを適用せず通常の20ステップで生成します。公式T2Vテンプレート
768p版へ差し替える際は、上の表に合わせてステップ数と動画・音声シフトを設定します。配布元のワークフローにはlora_name、steps、shift_video、shift_audioの入力があり、これらを一組で変更する手順が示されています。公式テンプレートの初期設定と、配布元のEulerを使う推奨構成は区別して確認できます。配布元のワークフローと設定手順
Redditでの速度・動き・音声の評価
8-step v1.0の公開スレッドには、RTX 5090・0.5 MP・15秒指定で、通常20ステップの約250〜300秒から、Turbo 8ステップの約110〜130秒へ短縮したという利用者の報告があります。同じ利用者は、通常版のほうがプロンプトに沿いやすいとも述べています。ほかにも良好な映像・音声が得られたという投稿と、動きがスローモーションのようになる、音声に問題が残るという投稿があり、評価は分かれています。8-step v1.0の利用者報告
その後の4-step v1.2のスレッドには、1344×768・4ステップの作例が投稿され、4ステップとして音声を評価する声もあります。Ref2VA 8-step 768pのスレッドでは、試用後も粒状感やぼけが残ったという報告が出ています。これらはそれぞれの版と生成条件での利用者評価です。映像の細部、動き、音声を確認するときは、FL2VA/Ref2VA、版番号、学習解像度、ステップ数をそろえて読む必要があります。4-step v1.2の議論、Ref2VA 8-step 768pの議論
Spectrum:途中の特徴を予測してTransformer計算を減らす
Spectrumは、過去の生成ステップで得た特徴から、次の特徴を予測する高速化手法です。ComfyUI-Spectrum-MiniMax-H3は、これをH3の映像・音声生成へ組み込むカスタムノードです。実際にH3を計算するステップを残し、一部のステップでは予測した特徴を使ってTransformerの計算を省きます。SpectrumのH3実装
ワークフローでは、H3モデルの読み込み、LoRAなどの適用、Sigma Shiftの設定を行った後に、Spectrum Apply MiniMax H3を置きます。そのモデル出力をguiderとsamplerへ渡します。現行版の通常の20ステップ構成は、追加の再計算がなければ、11回の実計算と9回の予測になることがあります。接続順と現行設定
作者のv0.1.8の比較では、pruned BF16、992×768、7秒、24fps、20ステップ、EulerとBeta schedulerを使い、サンプリング時間が324.98秒から177.80秒へ短縮しました。全処理時間は340.59秒から200.32秒で、サンプリング部分の短縮率は45.29%、全処理では約41%です。条件付きの速度比較
その後、利用者による同一seedの比較で音声の劣化も報告されました。現行版は、音声品質を保つためのoffline smoothing replayを備え、audio_blend_weight=0.0を初期設定にしています。古い速度投稿の設定と、現行版の音声処理には変更があります。音声処理を変更した更新投稿、現行実装
Spectrumは予測を使う近似的な高速化なので、同じseedでも無効時とは生成結果が変わり得ます。Redditでは速度だけでなく、動作や音声をどの程度保てるかも議論されています。
FirstBlockCache:変化が小さいステップで後段の計算を再利用する
FirstBlockCacheは、毎ステップで最初のTransformerブロックを計算し、その変化が小さい場合に、残りのブロック群の計算結果を再利用するカスタムノードです。H3用の実装は、追加モデルや追加のPythonパッケージを必要としないMODELパッチノードとして配布されています。H3 FirstBlockCache
作者のRTX 5090での比較条件は、H3 INT8 ConvRot、0.5 MP、5秒、20ステップ、モデル読み込み済みの状態です。
| Attention | キャッシュ無効 | Fast使用 |
|---|---|---|
| Native Attention | 90.64秒 | 60.82秒 |
| SageAttention2 | 57.96秒 | 40.26秒 |
同じAttentionを使った比較で、キャッシュによる時間短縮はそれぞれ32.9%、30.5%でした。SageAttention2自体の効果は、このキャッシュ単独の短縮率に含まれていません。計測条件と結果
Safe、Fast、Aggressiveなどのプリセットがあり、作者の推奨初期設定はFastです。Aggressiveは再利用の判断を緩めるため、生成の軌道も大きく変わり得ます。配線はモデル読み込みとguider・schedulerの間に入れ、パッチ後のMODELを使用先へ渡します。
EasyCache、LazyCache、CacheDiTなど、同じブロックを置き換えるキャッシュとの併用には制約があります。対応する組み合わせを確認して導入する必要があります。接続方法と互換性
Redditの公開投稿には、同じseedの比較動画と速度の内訳があり、変更される動きも含めて確認できる形になっています。Redditの紹介投稿
RefModsとFantastic Prompt Builder:人物・声・参照素材を再利用する
RefModsは参照素材を保存する仕組み
RefModは、人物の写真、場所や動きを示す動画、声の音声などを、H3で再利用できる参照セットとして保存する仕組みです。参照素材をエンコードして保存するため、作成時に追加学習を行う必要がありません。複数の人物写真をまとめたり、人物の見た目と声を一組にしたりできます。RefModsガイド
保存先はComfyUI/models/refmodsです。ライブラリでは、名前・説明・プレビューを付け、素材の追加、フレームの並べ替え、声の差し替えなどを行えます。生成ごとに素材を読み込み直して整える操作を減らし、同じ参照セットを複数の場面へ持ち込めます。
FullとCompressedは、残す参照情報と負荷が異なります。
| 保存方式 | 主に残す情報 | 向く素材 |
|---|---|---|
| Full | 顔や物体の細部、動き | 人物、製品、文字、動作 |
| Compressed | 色、配置、形、全体の雰囲気 | 背景、スタイル、多数の参照 |
Fullは参照情報が多く、生成時の負荷も増えます。声を保存する場合は、音楽や背景音が混ざらない、一人の声の録音が扱いやすくなります。保存方式と声の扱い
Fantastic Prompt Builderはプロンプトと参照の対応を管理する
Fantastic H3 Prompt Builderは、H3のモードごとにプロンプトを組み立てる入力画面です。ショット、カット時刻、話者、セリフ、参照メディアのタグを扱い、ショット番号の順序や参照の欠落などを確認します。Media Loaderでは画像・動画・音声をプレビューし、トリミングやクロップを行えます。Fantastic Prompt Builder
RefModsを使う構成では、Fantastic H3 RefMod Stackへ参照セットを登録し、Fantastic H3 RefMod Text Encodeでメディアと一緒にエンコードします。RefMod Text Encodeは、通常のReference to Videoノードに代わる位置で使います。配布例には、このノードパックとComfyUIのコアノードで動くVanilla版もあります。配布ワークフローと接続
現行版は、テキストエンコーダーへ見せる参照画像をRefMod内に保存し、毎回のデコードを減らします。見せる画像の枚数を増やすと、人物の再現や人物同士の特徴の混ざりに影響する一方、メモリと生成時間も増えます。
動画の部分編集も加わっています。Media Loaderで編集マスクを作り、RefMod Text Encodeで生成し、Fantastic H3 Edit Compositeで生成領域を元フレームへ合成します。マスクには図形やブラシなどが使え、自動マスクにはSAM 3.1のチェックポイントを使います。1.8系の更新内容
Redditの9月30日の更新投稿では、参照精度と人物の特徴の混ざりを減らす変更、部分編集が紹介されています。接続方法や使うモデルについての質問も多く、参照を使った制作の中心的な話題になっています。RefModsの更新投稿
FL2VA・Ref2VAハイブリッドは参照生成用のモデル選択肢
ハイブリッドモデルは、FL2VAをベースにして、後段の一部ブロックのAdaLN投影をRef2VAの重みへ置き換えたチェックポイントです。参照条件への対応と映像・音声の品質のバランスを調整する目的で配布されています。ハイブリッドモデル
Ref2VA由来の重みを使う範囲は、b30-49、b25-49、b20-49、b15-49の4種類です。配布者はb25-49を初めに試す候補に挙げ、より強い参照への追従が必要な場合にb20-49やb15-49を案内しています。この優先順位は配布者の主観的な出力比較に基づきます。
RefModsは参照素材の再利用、ハイブリッドは生成モデルの重みの構成を担当します。RefMod用ワークフローでも、Ref2VAまたは対応するハイブリッドを選ぶ構成が使われています。RefModsで使うモデル
H3 Latent Upscaler:低解像度で生成してから高解像度へ仕上げる
H3 Latent Upscalerは、H3の潜在表現を学習済みのネットワークで拡大するツールです。低解像度で生成した動画の潜在表現を拡大し、高解像度で再サンプリングしてからデコードする構成を作れます。途中で動画へデコードし、画像を拡大して再びVAEエンコードする往復を省けます。Latent Upscaler
ComfyUIの基本的な接続は、低解像度の生成結果、Latent Upscaler、仕上げ用のサンプリング、VAE Decodeの順です。
ノードには2D版と3D版があります。2D版は軽い計算で空間方向を拡大し、3D版は時間方向も含めた処理でフレーム間の整合性を扱います。3D版では倍率、目標の縦横サイズ、メガピクセル数で出力サイズを指定できます。モデルの重みは別途取得し、models/latent_upscale_modelsへ置きます。配布モデル、ノードの使い方
仕上げのサンプリングは目標解像度で行うため、この構成は高解像度側のメモリを必要とします。低解像度の初回生成と、選んだ結果だけを高解像度へ仕上げる操作を組み合わせる点が、制作時間に関わります。
同じノードパックには、時間方向と空間方向に分割して再サンプリングするMMH3 Split Upscaleもあります。こちらは分割した領域をH3で生成し直す処理を使い、分割の重なり、色合わせ、時間方向のアンカーを扱います。Split Upscaleの構成
Redditでは、低解像度からの仕上げによる画質の改善を評価する投稿と、仕上げやVAEの処理時間が長いという報告が両方あります。9月の画質に関する相談でも、H3専用のLatent Upscalerが具体的な選択肢として挙げられています。紹介と利用者の反応、画質についての議論
Endless H3とMotion Context:動きと音声を引き継いで長尺化する
Endless MiniMax H3は、短い動画を順番に生成し、前のクリップから情報を引き継いでつなぐワークフローです。ComfyUI-H3-Motion-ContextとH3 Motion Context Clip Stitcherを組み合わせ、各クリップの潜在表現を保存・読み込みしながら長い動画を作ります。Endless H3 v1.5
Motion Contextは、直前のクリップの末尾の映像と音声を、次のクリップの冒頭へ持ち込みます。現行の潜在表現を使う経路は、映像と音声を一組で引き継ぎ、画素へのデコードと再エンコードを繰り返す処理を減らします。Motion Context
これにより、最後の一枚の画像に加えて、直前の動く状態や音の流れを条件にできます。引き継ぎに使った重複部分はTrimやClip Stitcher側で処理し、完成動画へつなぎます。潜在表現でつなぐクリップは、解像度をそろえる必要があります。
Endless H3の配布ワークフローでは、クリップを生成して結果を選び、次へ進む操作と、直前の2クリップだけをつないで境界を確認する操作が用意されています。長い入力音声を区切って使うリップシンク用の構成もあります。ワークフロー内のMotion Context、Clip Stitcher、音声分割のcontext_lengthは同じ値にそろえます。配布ワークフローの操作と条件
v1.5の話題は、継続生成での動きやコントラストの劣化を減らすことです。Redditでの質問に対して、作者はコントラストの変化が内容によって残ると回答しています。長尺化と、長くつないだ際の品質維持は、それぞれ確認する対象になります。
Continuityは複数ショットを制作画面で管理する
Continuityは、旧MiniMax Creatorから発展したComfyUIの制作インターフェースです。プロンプトと参照メディアを一つの画面で扱い、ショットごとのプロンプト、参照、LoRAなどをタイムライン上で管理できます。Continuity
Chainedは各ショットを個別に生成してつなぎ、One passはショットの指定を一度の生成へまとめます。Chainedはショットごとの構成を変えやすく、One passは一回の生成で使える尺と、共通のモデル・LoRA・音環境の範囲で動きます。潜在表現の受け渡しや継ぎ目の設定も備えています。タイムライン
Storyboardは過去のショットを3×3の参照画像にまとめ、場所や物体を次のショットへ示します。参照画像の枠を一つ使い、構図も引き継ぎやすくなるため、カメラ位置を変えるショットでは影響を考慮する必要があります。
MotionFixは追加の生成処理で速い動きのフレームを扱います。開発者の例では改善した動作と、静かな場面で動きが変わった例があり、追加の計算時間も必要です。StoryboardとMotionFix
複数フレーム参照は動画途中の状態を指定する
ComfyUIの複数フレーム参照テンプレートは、Add Guide for MiniMax H3を使い、動画の途中の時刻へ画像を配置する構成です。配布例は人物の参照画像と、1.5秒・3秒・5秒のガイド画像を組み合わせています。途中でどの状態に到達させるかを画像で指定でき、連続生成に加えて時間方向の制御を増やす選択肢になります。複数フレーム参照テンプレート
Fun ControlNet Union 2.0:動作・構図・領域を映像で指定する
Fun ControlNet Union 2.0は、H3へ制御用の動画を与えるControlNetです。一つのチェックポイントで、輪郭、奥行き、ポーズ、描線、配置などの8種類を扱います。2.0ではScribble、Layout、Grayが加わり、制御ブロックは5個から10個へ増えています。Union 2.0
| 制御方式 | 入力する情報 |
|---|---|
| Canny | 輪郭線 |
| Depth | 奥行き |
| HED | エッジ |
| MLSD | 直線的な構造 |
| Pose | 人物の骨格・ポーズ |
| Scribble | 描線やスケッチ |
| Layout | 色分けしたボックスによる配置 |
| Gray | グレースケールの映像 |
例えば人物の動きを指定する場合は、ポーズの制御映像を使います。カメラや空間の構造を示す場合はDepthや輪郭を使い、Layoutでは白い背景に色付きのボックスを描いて、対象の配置を表します。制御方式と作例
元配布のチェックポイントは、約13.5 GBの制御ブランチです。H3のベースモデルと組み合わせ、制御の強さを調整して使います。ComfyUI 0.38.0にはUnion 2.0の対応が入り、公式のControlNetテンプレートも用意されています。ComfyUI 0.38.0、ControlNetテンプレート
マスクを使う動画のインペイントにも対応します。元配布のマスクは、白が再生成する領域、黒が保持する領域です。参照画像で人物の見た目を与える処理と、制御動画で動き・構造を与える処理を組み合わせる用途があります。
Redditでは初代公開から関心を集め、2.0への更新とともに、PoseやCannyなどの入力を作るReShotも紹介されています。ControlNetを使う際には、H3へ渡す制御動画を作る前処理も構成に含まれます。初代の公開投稿、Union 2.0とReShotの紹介
LynnReal-Omni:4ステップと3ステップのH3派生モデル
LynnReal-Omniは、H3の構成を利用した映像生成の派生モデルです。Standardは4ステップ、Flashは3ステップで動かし、専用のComfyUIノードパックとワークフローを組み合わせます。LynnReal-Omni
Standardには、テキスト、開始画像、参照画像・動画、ポーズ制御、動画の継続生成のワークフローがあります。Flashには、テキスト、開始画像、参照画像を使う生成があり、Light VAEを組み合わせます。ComfyUI向け構成
Lite版はチェックポイントの容量を減らす
現行の配布にはStandard LiteとFlash Liteがあります。
- Standard Lite BF16:37.6 GiB
lynnreal_omni_standard_bf16_lite.safetensors - Standard Lite INT8:20.4 GiB
lynnreal_omni_standard_int8_lite.safetensors - Flash Lite INT8:16.7 GiB
lynnreal_omni_flash_int8_lite.safetensors
Lite版は、配布された低ステップのスケジュールで使うAdaLNの値を表として保存し、モデルの容量を減らします。開発者のH100での比較では、指定スケジュールの生成途中の状態が元モデルと一致しています。Standard Liteは4ステップ、Flash Liteは3ステップを使い、別のステップ数やサンプラーはその一致の検証範囲に含まれていません。Lite版の仕組みと比較条件
これらはDiTファイルの容量です。実行にはテキストエンコーダー、VAE、中間データも必要になります。導入はLite版と対応するワークフロー、現行のComfyUI-LynnRealノードパックをそろえる構成です。
FlashのComfyUI向け実装は実験段階で、現行の注意事項には11秒を超える動画を利用できない制約があります。Redditの初期公開スレッドにも、画質やワークフローの接続、モデル容量への質問が出ています。現在の制約、Redditの公開スレッド
Light VAEは生成後の動画デコードを軽くする
LynnRealのLight VAEは、H3のエンコーダーを維持し、動画デコーダーを26ブロックに蒸留した構成です。潜在表現のチャンネル、正規化、空間と時間の圧縮率はH3のVAEとそろっています。同じ潜在データを復元しても、通常VAEとLight VAEで最終的なRGB映像が変わることがあります。Light VAE
LynnRealのFlash用ワークフローではLight VAEを使います。H3用には、Kijai氏のminimax_h3_lynnreal_light_vae_int8_convrot.safetensorsも配布されています。通常VAEのINT8 ConvRot化と、26ブロックのLight VAEへの変更は、それぞれ量子化とデコーダー構成の変更に当たります。Kijai氏のVAE配布説明
ComfyUI本体にもVAEの変更があります。0.36.0にはH3 VAEの最適化とメモリ使用量の改善、0.38.0にはタイルの境界処理などの修正が入っています。Light VAEの対応は別途追加された変更なので、使用するローダーと配布ワークフローの対応を確認する必要があります。0.36.0の変更、0.38.0の変更、Light VAE対応