Black Forest Labsが10月15日、画像生成・編集モデル「FLUX 3 Image Klein」の重みを公開しました。画像生成部分は5.6Bパラメータで、テキストからの生成、画像編集、最大10枚の参照画像を使う生成に対応します。ネイティブ4K生成と、画像内の要素の配置を座標で指定するバウンディングボックスも備えています。
FLUX.2からの変更は、小型化と配置制御、プロンプトの処理、利用ライセンスに及びます。一方、公開直後のRedditには、FLUX.2 [klein]より画質や編集結果が悪いという投稿も集まっています。新機能と初期の使用感には差が出ています。
今回公開されたFLUX 3 Image Klein
FLUX 3ファミリーは、画像・動画・音声を共通のアーキテクチャで学習し、行動予測にも展開するモデル群です。7月23日に発表され、今回のFLUX 3 Image Kleinは、その画像生成・編集をローカル環境で動かすための小型モデルに当たります。
公開されたチェックポイントは、生成・編集向けの蒸留版と、追加学習向けのBase版です。
| 公開モデル | 主な用途 | 標準の生成設定 |
|---|---|---|
| FLUX 3 Image Klein | 画像生成・画像編集 | 16ステップ、CFGなし |
| FLUX 3 Image Klein Base | ファインチューニング・LoRA学習・研究 | 50ステップ、guidance 3.5 |
5.6Bは画像Transformerの規模です。文章の特徴を抽出するQwen3-VL-4B-Instructは別に読み込みます。
ComfyUIとHugging Face Diffusersは公開初日から対応しています。ComfyUIは標準のモデルローダーを使い、テキストエンコーダーにはflux3タイプが追加されています。
FLUX.2と何が変わったのか
FLUX.2には、32BのFLUX.2 [dev]と、小型のFLUX.2 [klein] 4B・9Bがあります。FLUX.2 [dev]も、テキスト指示による生成・編集・複数画像の合成に対応します。今回のFLUX 3 Image Kleinとの比較では、同じ小型モデルであるFLUX.2 [klein]が中心になります。
| 比較項目 | FLUX.2 [klein] 4B | FLUX.2 [klein] 9B | FLUX 3 Image Klein |
|---|---|---|---|
| 画像生成部分の規模 | 4B | 9B | 5.6B |
| 蒸留版の標準ステップ数 | 4 | 4 | 16 |
| 生成と画像編集 | 同じモデルで対応 | 同じモデルで対応 | 同じモデルで対応 |
| 複数画像の参照 | 対応 | 対応 | 最大10枚 |
| Base版 | 公開済み | 公開済み | 公開済み |
| ライセンス | Apache License 2.0 | FLUX Non-Commercial License | FLUX Kommunity License v.1.0 |
5.6Bは9Bから約38%の削減に当たり、4Bとの比較では規模が増えています。また、蒸留版の標準ステップ数は4から16へ増えています。生成部分の規模は9Bより小さくなり、標準の反復回数は増える構成です。
生成と編集の統合、複数参照そのものはFLUX.2から引き継ぐ機能です。FLUX.2の上位モデルも最大4MPの出力や複数画像の参照に対応します。FLUX 3 Image Kleinではネイティブ4Kと、次の座標による配置制御に対応しました。
ローカルで4K素材を直接生成
FLUX.2 [dev]は最大4MPの生成に対応し、Qwen-Image-2.1の公式標準サイズは2048×2048や2752×1536です。
FLUX 3 Image Kleinは、5.6Bの公開モデルでネイティブ4K生成に対応します。アップスケールを挟まず、生成段階から4Kの素材をローカルで作れる点が、これらのモデルと比べた強みです。
バウンディングボックスで配置と編集位置を指定
FLUX 3 Image Kleinでは、文章にバウンディングボックスを組み合わせて、文字や被写体を置く場所を指定できます。座標は0〜1000の範囲で表し、[top, left, bottom, right]の順に記述します。要素ごとにID、範囲、説明を持たせる形式です。
画像編集では、参照画像内の元の位置と移動先を指定し、要素を移動できます。文字を上側へ、人物を右側へ配置するように、画面内の構成を数値で伝えられる点が特徴です。
ボックスは配置と大きさを誘導する仕組みで、要素が範囲の外へ広がったり、小さな要素が省略されたりする場合があります。編集対象の外側にも変更が及ぶ可能性があります。
専用のPrompt Upsamplerを追加
FLUX 3 Image Kleinには、短い指示を詳しい情景描写へ展開する「FLUX 3 Image Klein Prompt Upsampler」が付属します。Qwen3.5-9Bを追加学習した9Bの視覚言語モデルで、画像生成モデルとテキストエンコーダーとは別の構成要素です。
Prompt Upsamplerは、被写体、背景、照明、カメラ、色や素材、画面内の位置まで含めた文章を出力します。画像編集では参照画像も読み、変更後の場面全体を記述します。バウンディングボックス付きの指示にも対応します。
8GB GPU対応と生成速度
量子化モデルはFP8、INT8、NVFP4を用意しています。BFLの公開値では、INT8版はVRAM 8GBのNVIDIA GeForce RTX GPUで動作します。蒸留版の16ステップ・約1MP生成は、ComfyUI上のRTX 5090で約4秒、RTX 4070で9秒未満です。これはGPU上の画像生成時間で、プロンプトの展開や通信、待ち行列を含むAPI全体の時間とは測定範囲が異なります。
Hugging FaceによるDiffusersの測定では、H100 80GB・オフロードなし・16ステップで、1024×1024のテキスト生成が1.93秒、同じ解像度の参照画像1枚を使う編集が3.87秒です。参照画像のトークンも各ステップで処理するため、画像編集では計算量が増えます。
公式評価はFLUX.2 [klein] 9Bを上回る
BFLの内部評価では、FLUX 3 Image KleinはFLUX.2 [klein] 9Bに対し、テキストからの画像生成で91 Elo、画像編集で70 Elo上回りました。比較対象にはQwen-Image 2.1、Krea 2、Ideogram V4.5、FLUX.2 [pro]も含まれます。画像編集に対応するモデルを使った比較では、画像編集でも首位です。
この数値はBFLの内部評価における順位と差を示します。公開直後の利用者による評価には、次のような反対の結果も出ています。
Qwen Image 2.1との比較
リリース時期の近いQwen Image 2.1 と比較してみました。
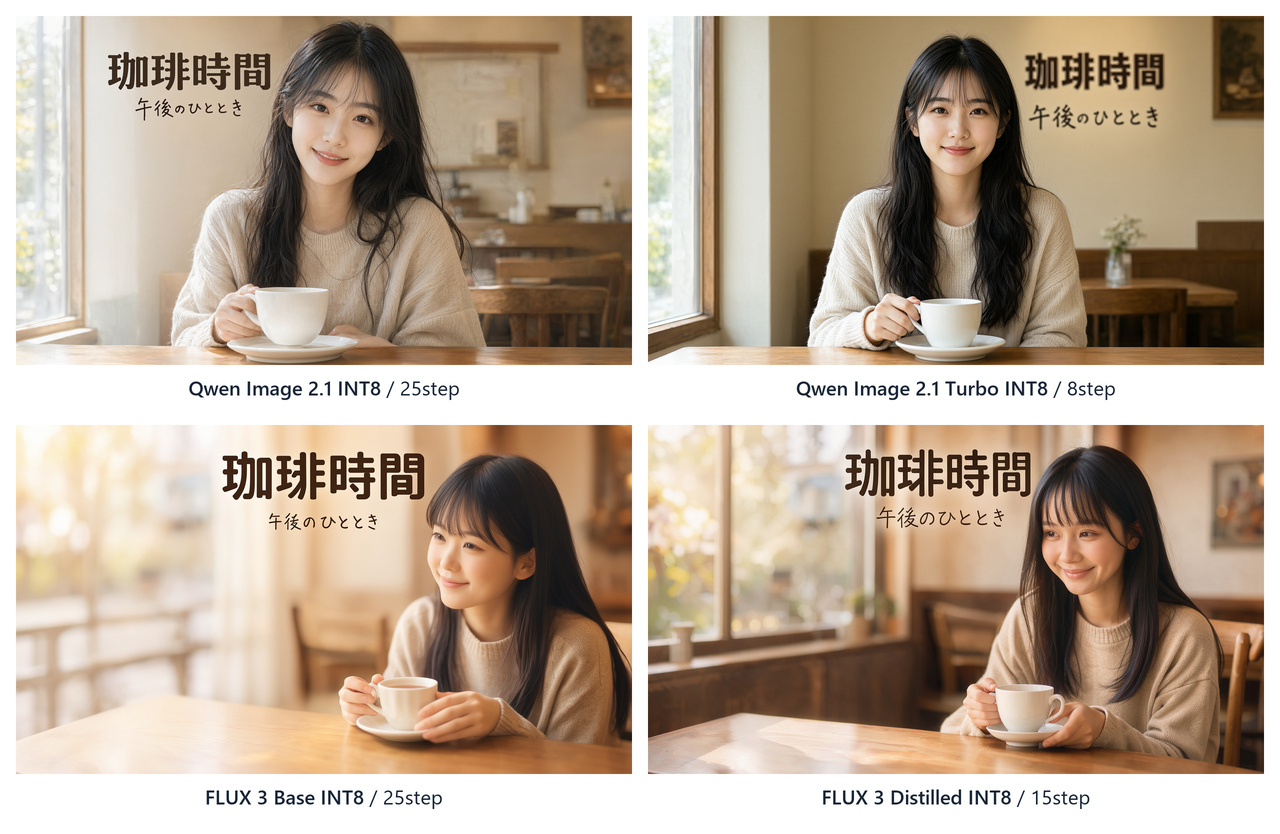
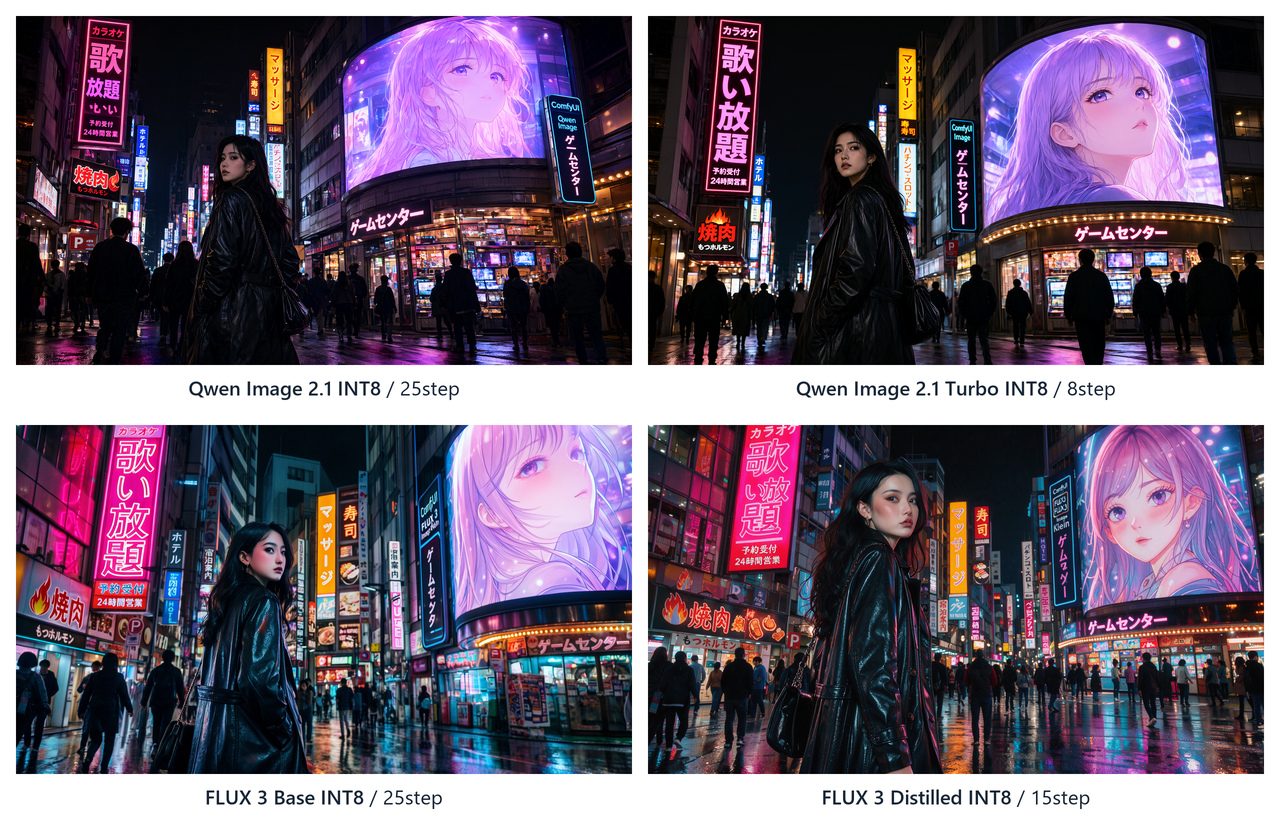
FLUX3は顔が崩壊しやすいです。
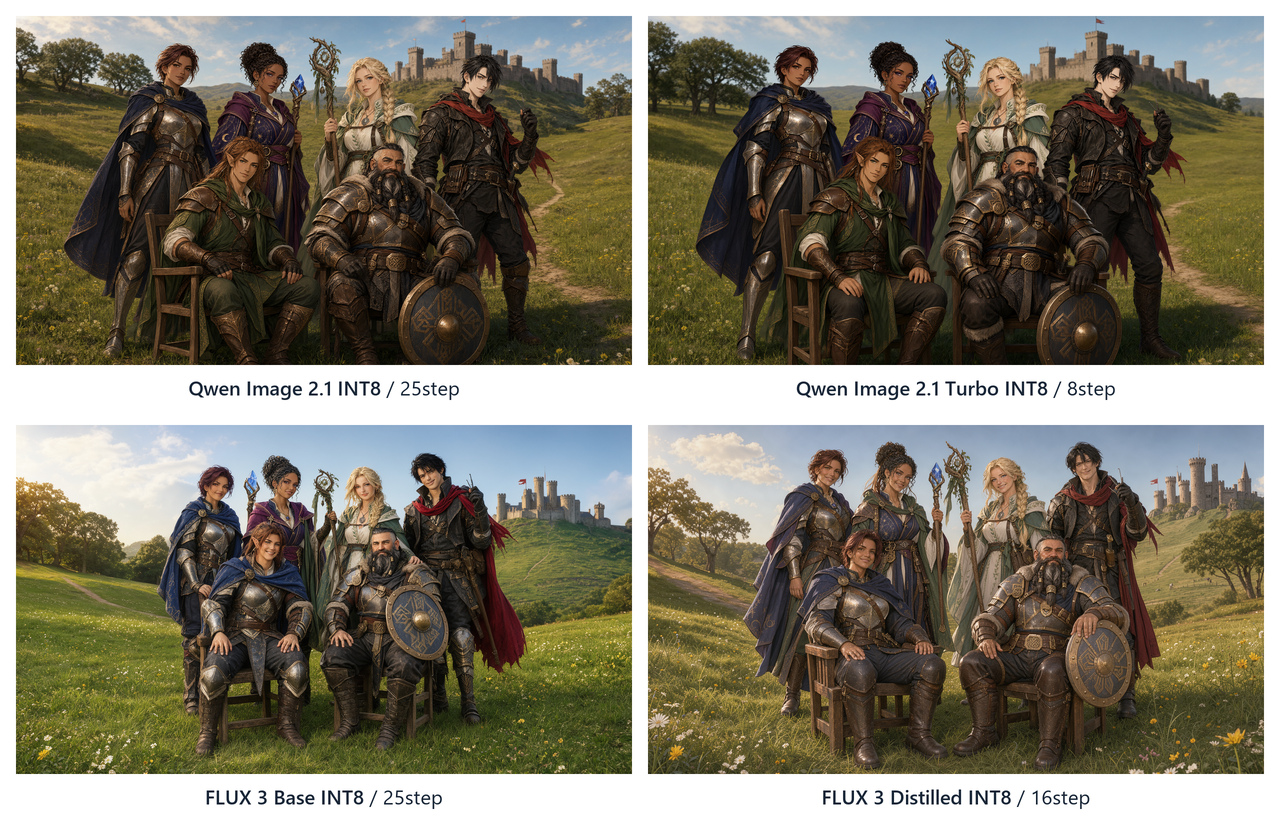
「6人全員がカメラに向かって温かく微笑む」という指定が入っています。
Qwenの方は元画像のキャラに忠実だが微笑まず、FLUX 3はプロンプトに忠実で微笑むがキャラの一貫性が弱いです。
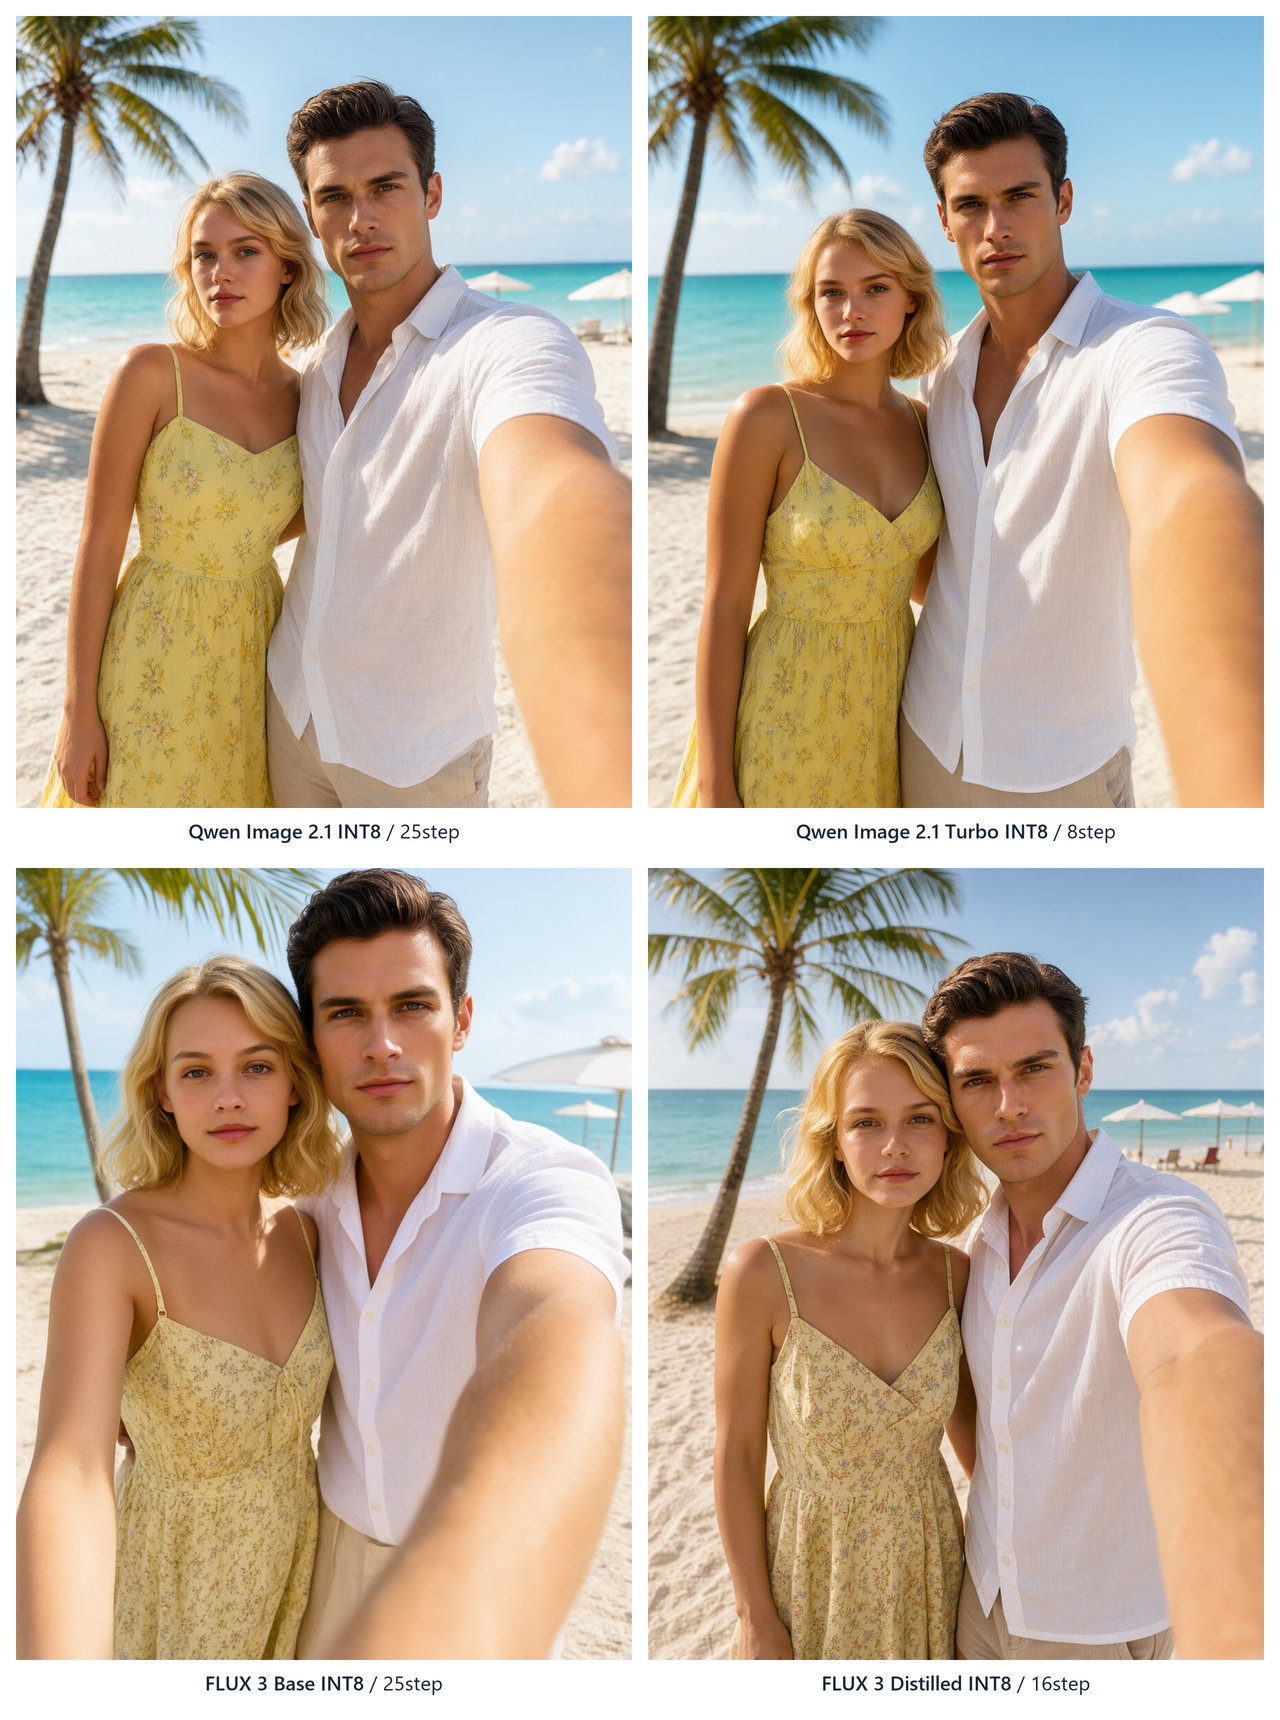
RedditではPEによる改善報告と描写への不満
10月15〜16日のr/StableDiffusionには、PEを省略した比較、PE使用前後の報告、詳しい文章を直接入力した生成例が投稿されています。
PEの使用で生成結果が大きく改善
「Flux 3 Klein as edit model」には、PEを使って結果が大きく改善したという返信があります。別の利用者は、草の上に横たわる女性の生成でPE使用前後の画像を投稿し、結果の変化を評価しています。PE使用後の改善報告
同じスレッドのBFLのStephen名義のコメントは、ComfyUIのワークフローでPEが既定で動かない問題と、その修正対応に触れています。公式の参照コードはPEを既定で実行し、ComfyUI向けのテキストから画像を生成するテンプレートにもPEの有効・無効を切り替える設定があります。BFL名義のコメント、公式のPE仕様
一方、同じスレッドにはPEが動作した後も結果に不満を示す返信があり、PE適用後の評価も分かれています。PE使用後も残る不満
人体描写とFLUX.2との比較
人体の描写では、手足の形や本数への批判が出ています。BFLの公開サンプルにも、人物の脚が3本に見えるという指摘がありました。人体描写への反応、公開サンプルへの指摘
10月16日の「Flux 2 Klein Vs Flux 3 Klein」では、投稿者は人体や顔の細部を理由にFLUX.2 [klein] 9Bを高く評価しています。RTX 3090・約1MP・BF16で、FLUX.2 [klein] 9Bは8ステップで7秒、FLUX 3 Image Klein蒸留版は15ステップで12秒、Base版は50ステップで82〜84秒でした。PEは省略し、短い指示や抽象的な指示も含む比較です。FLUX.2との比較条件と結果
文字生成と蒸留版の速度を評価する投稿も
「Flux 3 Klein base vs distilled, tested locally」の投稿者は、RTX A4500 20GBで、50種類のプロンプトを使ってBase版と蒸留版を比較しています。約2MP、Base版50ステップ・CFG 3.5、蒸留版15ステップ・CFG 1で、生成時間はそれぞれ約148秒と約24秒でした。
この投稿は、中国語や日本語の看板などの文字生成を評価しています。一方で、ネオンサインの文字や物体の数には誤りも残りました。Prompt Upsamplerは使わず、画風、構図、人物、背景、光を含む長いキャプション形式の文章を用いています。掲載画像は50種類から選んだ10例です。Base版と蒸留版のローカル比較
軽い環境での動作とライセンスにも反応
公開を知らせるスレッドには、重みの公開やComfyUI対応を歓迎する声があります。8GBのGeForce RTX 2070 SUPERで動作し、INT8版・16ステップ・約1MPで1枚約30秒だったという利用者の報告も出ています。公開直後の反応
ライセンスについては、ローカル生成アプリへの同梱や商用展開の条件に不満を示すコメントがあります。重みを公開したことへの歓迎と、再配布や事業利用の条件への警戒が同時に出ています。
FLUX Kommunity Licenseへ変更
FLUX 3 Image KleinはFLUX Kommunity License v.1.0を採用しています。関連会社を含む年間換算総売上高が500万米ドル未満なら、出力確認などの条件付きで生成画像を商用利用できます。商用の追加学習やモデル配布には別途ライセンスが必要です。
FLUX 3 Image Kleinの新機能と初期評価
FLUX 3 Image Kleinは、5.6Bの画像生成モデルに4K生成、座標による配置制御、専用のPEを組み合わせています。Redditの初期評価には、人体や編集への不満に加え、PEを使った大きな改善や文字生成を評価する声もあります。PEを省略した比較結果と、PE適用後の使用感には違いが出ています。